Áudio
Áudio no navegador, nas duas direções.
Reprodução — notificação sonora (chime de mensagem, confirmação de pagamento) com playAudio, useAudio e createAudioPlayer, e o componente AudioPlayer quando você precisa de transporte (play/pause, barra, tempos).
Captura — AudioRecorder pra uma nota de voz em uma linha, e por baixo useMediaPermission, useMediaDevices, useMicrophone, useAudioRecorder, createLevelMeter e blobToWav. Nenhuma dependência nova: a fatia inteira mede 5,50 KB brotli.
Se você só quer gravar uma nota de voz, pule para Gravação
O resto da página é a camada de baixo, pra quando o componente não serve.
Por que um wrapper em volta de new Audio()?
Tocar som no navegador esbarra na autoplay policy e em vazamento de elementos Audio. O SDK encapsula: rastreia o clipe atual (pra dar stop), normaliza volume, trata o bloqueio de autoplay devolvendo null em vez de estourar, e limpa no unmount quando você usa o hook.
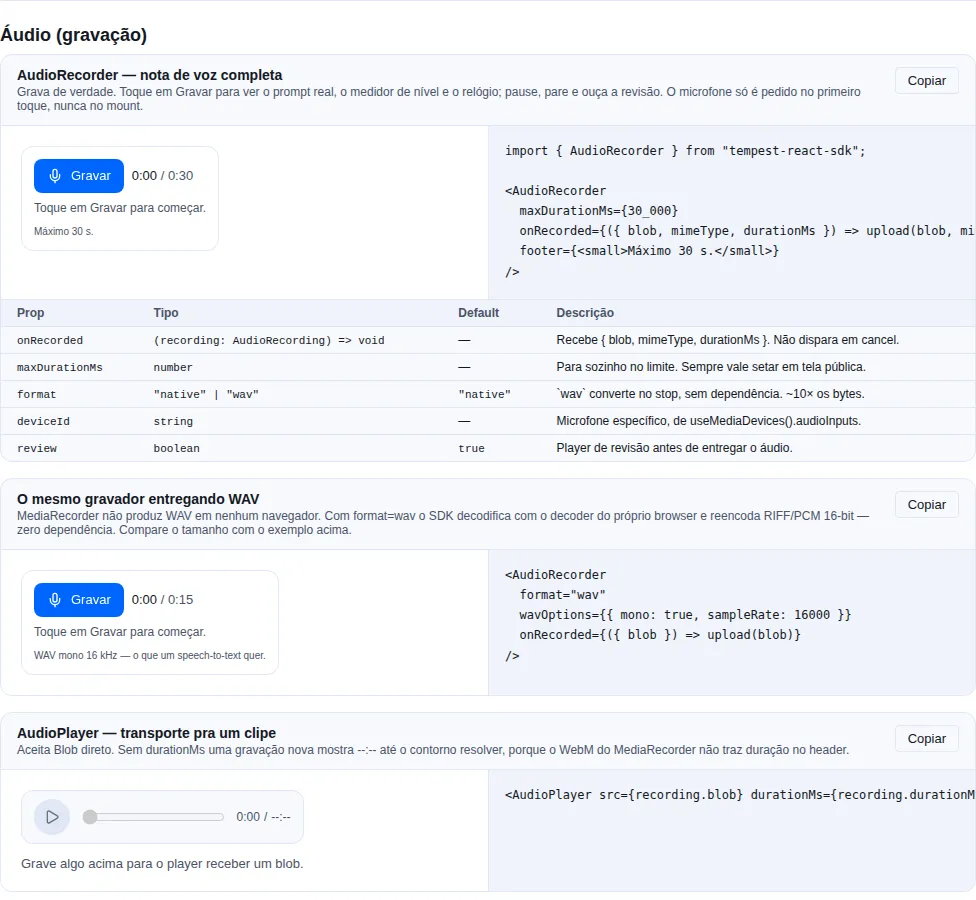
Seção audio-capture da gallery — rode localmente para interagir.
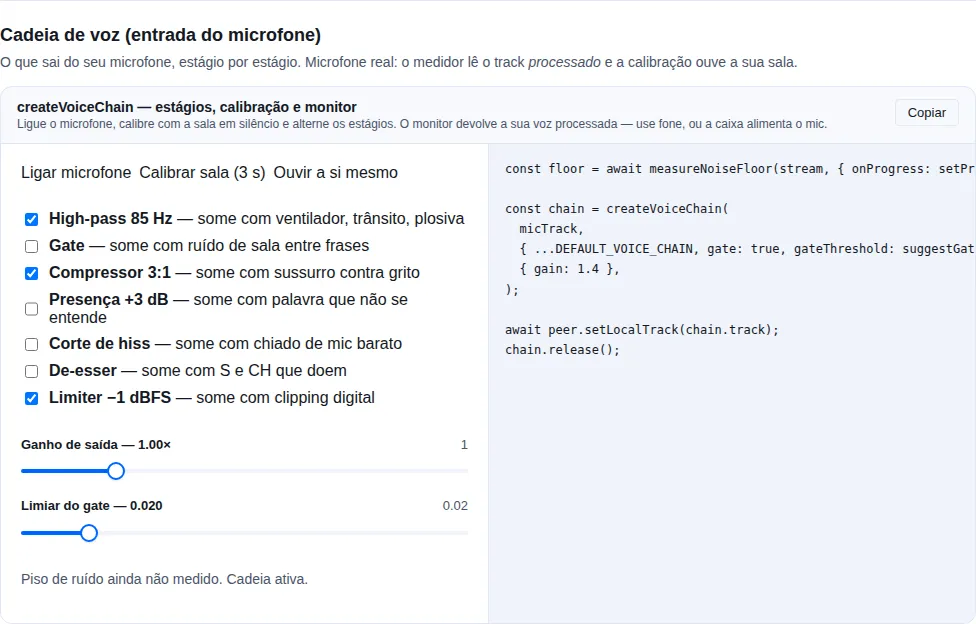
Seção voice-chain da gallery — rode localmente para interagir.
playAudio — one-off no player compartilhado
Ideal pra um som disparado por um evento, sem estado de UI:
import { playAudio, useEventStream } from "tempest-react-sdk";

interface StreamEvent {
  type: "NOTIFY" | "PAYMENT-SUCCESS";
}

export function PaymentSounds() {
  useEventStream<StreamEvent>(`${import.meta.env.VITE_API_URL}/notifications`, {
    onMessage: ({ data }) => {
      if (data.type === "PAYMENT-SUCCESS") {
        void playAudio("/audio/dinheiro.mp3", { volume: 0.5 });
      }
    },
  });

  return null;
}
playAudio(src, options) retorna Promise<HTMLAudioElement | null> — null quando o navegador bloqueou o autoplay. Opções: volume (0–1, default 1), loop, autoplay, stopPrevious, onEnded, onError. Pra parar o que o player compartilhado está tocando, use stopAudio().
useAudio — player privado por componente
Cada instância do hook tem seu próprio player, então desmontar para o áudio automaticamente:
import { useAudio } from "tempest-react-sdk";

export function NotificationBell() {
  const audio = useAudio();

  return (
    <button onClick={() => audio.play("/audio/plim.wav", { volume: 0.8 })}>
      🔔 {audio.unlocked ? "" : "(toque pra ativar som)"}
    </button>
  );
}
audio.play(src, options)— toca no player privado (mesmas options doplayAudio).audio.stop()— para o clipe atual.audio.unlocked— viratrueapós o primeiroplay()bem-sucedido. Útil pra esconder UI que pede a interação inicial.- Cleanup automático no unmount.
Use unlocked pra guiar o usuário
Antes do primeiro clique, o navegador bloqueia áudio. Mostre uma dica ("toque pra ativar som") enquanto unlocked === false e esconda assim que ele virar true.
createAudioPlayer — canais isolados
createAudioPlayer() cria um tracker independente do default. Use quando precisar tocar dois sons simultaneamente sem que um corte o outro (ex.: música de fundo + efeito sonoro):
import { createAudioPlayer } from "tempest-react-sdk";

const music = createAudioPlayer();
const sfx = createAudioPlayer();

await music.play("/audio/loop.mp3", { loop: true, volume: 0.3 });
await sfx.play("/audio/coin.wav", { volume: 1 }); // não corta a música

music.stop(); // para só a música
console.log(sfx.current()); // HTMLAudioElement | null
Cada player rastreia um clipe atual. stopPrevious: true no play() para o clipe anterior daquele mesmo player antes de tocar o novo.
createSfxPool / useSfxPool — efeitos sonoros curtos
new Audio(src) a cada disparo aloca um elemento e re-entra na pilha de rede por um arquivo que o navegador já tem. Para um som que toca dezenas de vezes por minuto — um blip de menu, um hit, um pickup — é a forma errada. O pool aloca uma vez por fonte e reproduz.
import { useSfxPool } from "tempest-react-sdk";

function Menu({ sfxVolume }: { sfxVolume: number }) {
  const sfx = useSfxPool({ volume: sfxVolume / 100, baseUrl: import.meta.env.BASE_URL });

  useEffect(() => {
    sfx.preload(["sfx/move.mp3", "sfx/select.mp3", "sfx/back.mp3"]);
  }, [sfx]);

  return <button onClick={() => sfx.play("sfx/select.mp3")}>Confirmar</button>;
}
play(src, { volume })— o volume por play é multiplicado pelo master do pool.preload(src | src[])— busca antes do primeiro disparo, pra ele não sair mudo enquanto o arquivo baixa.setVolume(v)— aplica também no que já está soando, reescalando pelo ganho de cada um: um clipe que começou a meio volume não é puxado pra cima.stop(src?)— para uma fonte, ou todas.dispose()— libera tudo. OuseSfxPooljá chama no unmount.
voices: repetir ou sobrepor
O default (voices: 1) reinicia o clipe a cada play, que é o que um blip de menu quer. Suba pra deixar o som se sobrepor — um hit tocando enquanto o anterior ainda ressoa:
const hits = createSfxPool({ voices: 3 });
Não confunda com createAudioPlayer
createAudioPlayer rastreia um clipe atual, com loop, roteamento de saída e callbacks de ciclo de vida — é o que música de fundo precisa. Efeitos são o caso oposto: muitas fontes, todas curtas, dispara-e-esquece, e o que importa é que disparar seja barato.
Mudar volume no useSfxPool chama setVolume no pool existente em vez de recriá-lo — recriar jogaria fora todo elemento que o usuário já baixou, que é exatamente o custo que o pool existe pra evitar. baseUrl, voices e maxSources são lidos uma vez, na criação.
AudioPlayer — transporte visível
Quando usar: quando o usuário precisa controlar a reprodução, não só
ouvi-la — um áudio de mensagem, um take gravado, um anexo. playAudio dispara e
esquece; AudioPlayer dá play/pause, barra arrastável e os tempos.
import { AudioPlayer, Button } from "tempest-react-sdk";
import { Trash } from "lucide-react";

export function Gravacao({ blob, apagar }: { blob: Blob; apagar: () => void }) {
    return (
        <AudioPlayer
            src={blob}
            durationMs={12_400}
            actions={
                <Button variant="ghost" iconOnly aria-label="Apagar" onClick={apagar}>
                    <Trash size={16} />
                </Button>
            }
        />
    );
}
Passe durationMs quando você já souber a duração
Um Blob gravado no browser costuma vir sem cabeçalho de duração, e o
<audio> reporta Infinity até tocar até o fim. A barra fica travada nesse
intervalo. Se o gravador já te deu o tempo, passe-o — o componente usa esse
valor até o metadado real chegar.
Autoplay policy
Navegadores bloqueiam playback antes da primeira interação do usuário. playAudio / play() retornam null quando bloqueado (e chamam onError se passado) — em vez de lançar.
Destrave o áudio no primeiro clique
Não dá pra tocar som antes de qualquer interação. Desenhe o app pra disparar um play() (mesmo de um clipe silencioso curto) no primeiro clique de qualquer botão; a partir daí o navegador libera os próximos.
Assets
O SDK não embute áudios. Sirva em /audio/* (ou CDN) e passe a URL. Inspiração de paleta sonora (alofans):
export const AUDIOS = {
  plim: "/audio/plim.wav",
  dinheiro: "/audio/dinheiro.mp3",
  notification: "/audio/bell_sound.wav",
};
Gravação: comece pelo componente
Se você só quer uma nota de voz, é uma linha. O AudioRecorder cuida da permissão, do medidor de nível, do relógio e da revisão antes de você receber o áudio:
import { AudioRecorder } from "tempest-react-sdk";

export function NotaDeVoz({ ticketId }: { ticketId: string }) {
  return (
    <AudioRecorder
      maxDurationMs={120_000}
      onRecorded={({ blob, mimeType, durationMs }) => {
        const form = new FormData();
        form.append("audio", blob, `nota.${mimeType.includes("mp4") ? "m4a" : "webm"}`);
        form.append("duracao", String(durationMs));
        void fetch(`/api/tickets/${ticketId}/audio`, { method: "POST", body: form });
      }}
      footer={<small>Máximo 2 minutos.</small>}
    />
  );
}
O que você ganha sem escrever nada:
| Você fez | O componente faz |
|---|---|
| nada | Não pede o microfone no mount — só no primeiro toque em Gravar |
| nada | Se a permissão já está denied, diz isso e como resolver, em vez de oferecer um botão que não funciona |
| nada | Medidor de nível ao vivo, relógio que desconta pausa, pausar/continuar |
maxDurationMs |
Para sozinho no limite, e mostra o limite ao lado do relógio |
| nada | Player de revisão com transporte, e "Gravar de novo" reaproveitando o mesmo stream |
format="wav" |
Converte antes de te entregar, então o onRecorded sempre dá o formato que você pediu |
O prompt de permissão não é disparado no mount, e isso é a decisão mais importante da página
Um prompt que o usuário não provocou é a forma mais confiável de ganhar um Block permanente — e depois disso o getUserMedia rejeita sem nunca mais perguntar. Por isso o microfone abre no primeiro toque em Gravar, e o toque sobrevive ao round-trip: o componente arma a gravação e começa quando o stream chega. Esperar um segundo clique faria o primeiro parecer quebrado.
Props
| Prop | Tipo | Default | O que faz |
|---|---|---|---|
onRecorded |
(recording: AudioRecording) => void |
— | Recebe o áudio pronto. Não dispara em cancelamento. |
maxDurationMs |
number |
— | Para sozinho. Vale sempre setar em tela pública. |
deviceId |
string |
— | Microfone específico, de useMediaDevices().audioInputs. |
format |
"native" \| "wav" |
"native" |
"wav" converte no stop. Veja o custo abaixo. |
wavOptions |
WavOptions |
— | { mono: true, sampleRate: 16000 } serve pra fala. |
audioBitsPerSecond |
number |
— | 32000–64000 basta pra voz em Opus. |
review |
boolean |
true |
Player de revisão antes de entregar. |
locale |
"pt-BR" \| "en" |
"pt-BR" |
Rótulos. |
footer |
ReactNode |
— | Dica, contagem, aviso legal. |
onError |
(error: unknown) => void |
— | Falha do gravador, ou conversão WAV que não deu. |
AudioRecording = { blob, mimeType, durationMs }.
AudioPlayer — transporte pra um clipe
Aceita Blob direto, porque o que um app mais toca é a gravação que ele acabou de fazer:
<AudioPlayer src={recording.blob} durationMs={recording.durationMs} />
<AudioPlayer src="/audio/briefing.mp3" sinkId={saidaEscolhida} />
Passe durationMs sempre que tiver — o <audio> mente sobre gravação nova
O MediaRecorder escreve WebM sem duração no header, então <audio>.duration de uma gravação fresca é Infinity. É por isso que o gravador mantém o próprio relógio e você deve repassá-lo. Sem ele o componente aplica o único contorno que existe — buscar além do fim pra forçar o browser a demuxar até o último frame — e a barra fica travada até isso resolver.
| Prop | Tipo | Default | O que faz |
|---|---|---|---|
src |
string \| Blob \| null |
— | URL ou blob. Blob vira object URL com revoke automático. |
durationMs |
number |
— | Duração conhecida. Ganha do <audio>. |
sinkId |
string |
— | Saída escolhida. Só Chromium. |
autoPlay · loop |
boolean |
false |
Como no elemento nativo. |
actions |
ReactNode |
— | À direita dos tempos — baixar, apagar. |
onEnded · onError |
() => void |
— | Fim e falha de decode/rede. |
Permissão sem disparar o prompt
useMediaPermission lê o estado sem pedir o dispositivo. É o que torna um fluxo decente possível:
import { useMediaPermission } from "tempest-react-sdk";

export function BotaoDeGravar({ onStart }: { onStart: () => void }) {
  const { state, supported } = useMediaPermission("microphone");

  if (state === "denied") {
    return <p>Microfone bloqueado. Libere nas configurações do site e recarregue.</p>;
  }
  return (
    <button onClick={onStart}>
      {state === "prompt" || !supported ? "Permitir microfone e gravar" : "Gravar"}
    </button>
  );
}
| Estado | Significa | O que a UI deve fazer |
|---|---|---|
"prompt" |
nunca pediu | botão; pedir mostra o prompt |
"granted" |
liberado | botão normal |
"denied" |
sticky — pedir de novo rejeita na hora, sem prompt | instrução pras configurações do site, não botão |
"unknown" |
Permissions API não respondeu (Safari não expõe microphone) |
trate como "vai ter que pedir pra descobrir" |
O estado é ao vivo: se o usuário mudar a permissão nas configurações do site, o hook atualiza.
Dispositivos: microfone e saída
import { useMediaDevices, isAudioOutputSelectionSupported } from "tempest-react-sdk";

const { audioInputs, audioOutputs, labelsAvailable } = useMediaDevices();
Os nomes só aparecem depois da permissão
Antes de o usuário liberar uma captura, todo label é "" — os ids e a contagem são reais, os nomes não. Um seletor renderizado ali é uma coluna de vazios. Use labelsAvailable pra decidir quando mostrar. Peça o microfone primeiro, depois ofereça a escolha.
A lista muda com a página aberta
Plugar um fone no meio da gravação é o caso normal, não borda. O hook assina devicechange em vez de enumerar uma vez no mount.
audioOutputs vem vazio onde o browser não tem roteamento de saída — Safari e Firefox não implementam setSinkId. Vazio ali significa "você não pode oferecer essa escolha", não "não há alto-falantes". Cheque com isAudioOutputSelectionSupported() antes de renderizar o seletor, ou o controle é uma mentira em dois dos três motores.
import { setAudioOutput } from "tempest-react-sdk";

const ok = await setAudioOutput(audioRef.current, dispositivoEscolhido);
if (!ok) toast("Este navegador não permite escolher a saída de som.");
playAudio também aceita sinkId, útil pra um chime cair no fone enquanto o áudio da chamada fica no alto-falante.
Ganho acima de 100%: createAudioBus
Quando usar: você precisa subir o volume de uma fonte, misturar várias e mandar tudo para um dispositivo escolhido. Chamada com volume por participante é o caso típico.
element.volume é clampado em 1. Ou seja, um participante que fala baixo só pode ser abaixado — a única correção que ninguém precisa. Subir acima de 100% exige um grafo WebAudio, e montá-lo direito esbarra em três coisas não-óbvias, que é o que este barramento embala.
import { createAudioBus } from "tempest-react-sdk";

const bus = createAudioBus({ maxGain: 3 });

const handle = bus.attach(streamRemoto, { gain: 1 });
handle.setGain(2.4); // acima de 1 — o ponto da coisa toda
handle.stop();

bus.setMasterGain(1.2);
await bus.setOutputDevice(idDoFone); // "" = padrão do sistema
bus.close();
No React, useAudioBus faz o mesmo e fecha o contexto no unmount:
import { useAudioBus } from "tempest-react-sdk";
import { useEffect } from "react";

function Participante({ stream, volume }: { stream: MediaStream; volume: number }) {
  const bus = useAudioBus({ maxGain: 3 });

  useEffect(() => {
    const handle = bus.attach(stream);
    return () => handle.stop();
  }, [bus, stream]);

  return <Slider value={volume} onChange={(v) => bus.setMasterGain(v)} aria-label="Volume" />;
}
As três armadilhas que o barramento resolve
O bug do Chrome que deixa o grafo mudo
Um MediaStreamAudioSourceNode sobre um stream remoto de WebRTC não produz amostras no Chrome a menos que o mesmo stream esteja também preso a um elemento de mídia (crbug.com/687574). O grafo fica visivelmente correto e completamente silencioso — sem conhecer o bug, é um dia de depuração. O attach() cria um <audio muted autoplay> de âncora para você. Ele parece código morto e não é: apagá-lo emudece a chamada inteira no Chrome.
O limiter fica depois da soma, nunca por fonte
Clipping é propriedade da mistura, não do participante: três pessoas a 200% cada ficam limpas sozinhas e distorcem no instante em que falam juntas. Um limiter por participante não enxerga isso; o do master enxerga. Ajuste com limiter: { threshold: -3 }, ou desligue com limiter: false.
setSinkId mora no elemento, não no contexto
Mandar a chamada para o fone enquanto o resto do sistema fica no alto-falante só é alcançável saindo por MediaStreamAudioDestinationNode → <audio> → setSinkId. AudioContext.setSinkId tem suporte bem menor, então a mistura sai por um elemento real. bus.canSelectOutput diz se o motor permite: no Safari e em todo browser iOS a saída segue a rota do sistema, e o seletor deve ser escondido, não oferecido e ignorado.
Detalhes que evitam surpresa
- O teto é seu.
maxGain(defaultDEFAULT_MAX_GAIN, que é3) limita fonte e master. Acima de ~3 a fala já chega distorcida antes de ficar mais alta. - Ganho é clampado, e
NaNvira1.NaNchega de um campo numérico vazio ou de um parse que falhou, e atribuí-lo a umAudioParamlança — perder o áudio por causa de um typo num input é um preço alto. - Contexto é caro. Browsers limitam quantos
AudioContextvivem ao mesmo tempo (Chrome permite ~6). Passecontextpara reaproveitar o que a página já tem, e chameclose()(ou use o hook) quando terminar. resume()para a autoplay policy. Um contexto criado fora de um gesto do usuário nasce suspenso — e suspenso é silencioso sem erro nenhum. Chameresume()no clique que inicia a reprodução.- Depois de
close(), o barramento continua chamável.attach()devolve um handle inerte em vez de lançar — não é gentileza: criar nó numAudioContextfechado lançaInvalidStateError, e o stream que chega tarde é o caso normal (umontrackde WebRTC disparando depois que o componente dono do bus saiu da tela). - Sem Web Audio, o barramento é inerte, não explode.
supported: false, todos os métodos continuam chamáveis. Uma página sem som é melhor que uma página que quebra.
Progress não serve como medidor de áudio
O fill do Progress tem transition: width, então a barra reporta onde o nível esteve — a única coisa que um medidor não pode fazer. Para nível ao vivo, use createLevelMeter e escreva no DOM dentro de um requestAnimationFrame.
Duas armadilhas se você desenhar o seu: a escala precisa ser em dB (numa linear a fala normal fica espremida no primeiro quinto), e o gradiente de cor precisa ficar no track com uma máscara por cima — num elemento que cresce, o gradiente é reescalado junto e pinta vermelho na ponta de um sinal fraco, reportando clipping para quem está quase inaudível.
Quem está falando: monitorVoiceActivity
Indicador de fala é a informação que todo cliente deriva de graça do track que já recebe. Sinalizar pelo servidor é o caminho errado: o estado muda várias vezes por segundo e a sala vira enxurrada de mensagens.
import { monitorVoiceActivity } from "tempest-react-sdk";

const vad = monitorVoiceActivity(remoteStream, (speaking) => setSpeaking(speaking));
// depois
vad.stop();
Duas coisas separam isso de um if (nivel > x):
- O release. O RMS cai a nada nas gaps entre palavras, então uma comparação pura pisca em toda sílaba. O estado só cai depois de
releaseMs(default 350 ms) de silêncio. onChangedispara na virada, não na amostra. Um callback por leitura re-renderizaria a lista de participantes dez vezes por segundo para dizer a mesma coisa.
O medidor por baixo roda com suavização desligada (decay: 0): o decaimento suave dele somado a este release seguraria o indicador aberto muito depois da fala.
Um contexto por participante estoura o limite do browser
Chrome permite ~6 AudioContext vivos, e uma chamada de cinco pessoas com um monitor cada chega lá. Abra um contexto e passe em context para todos os monitores — stop() fecha só o contexto que ele mesmo criou.
Entrada: createVoiceChain
createAudioBus cuida do que chega aos seus ouvidos. createVoiceChain cuida do que sai do seu microfone — e o que o browser entrega, mesmo com echoCancellation e noiseSuppression ligados, ainda é ronco de ventilador abaixo da fala, 20 dB entre um sussurro e um grito, e consoante que não lê.
import {
  createVoiceChain,
  DEFAULT_VOICE_CHAIN,
  measureNoiseFloor,
  suggestGateThreshold,
} from "tempest-react-sdk";

const floor = await measureNoiseFloor(stream, { onProgress: setProgress });

const chain = createVoiceChain(
  micTrack,
  { ...DEFAULT_VOICE_CHAIN, gate: true, gateThreshold: suggestGateThreshold(floor) },
  { gain: 1.4 },
);

await peer.setLocalTrack(chain.track);
// depois
chain.release();
Cada estágio existe por um sintoma
| Estágio | Some com | Default |
|---|---|---|
highPass (85 Hz) |
ventilador, trânsito, batida na mesa, plosiva | ligado |
gate (hold de 220 ms) |
ruído de sala entre frases | desligado |
compressor (3:1) |
a distância entre quem sussurra e quem grita | ligado |
presence (+3 dB @ 3 kHz) |
palavra que chega mas não se entende | desligado |
hissCut (9 kHz) |
chiado de microfone barato | desligado |
deEsser (@ 7 kHz) |
S e CH que doem no fone | desligado |
limiter (−1 dBFS) |
clipping digital, que o outro lado não recupera | ligado |
Os quatro desligados por padrão têm custo audível quando não são precisos: gate no limiar errado corta palavra, presença num microfone já brilhante machuca, de-esser numa voz que não sibila só abafa.
A ordem não é cosmética
Gate antes do high-pass deixa um ronco segurar o gate aberto. Compressor antes do gate levanta o piso de ruído até encostar no limiar. Limiter antes do ganho de saída é um teto por onde o ganho passa direto. A cadeia monta na ordem de uma mesa: corta o que não é fala, silencia o resto, nivela, molda, define o quão alto sai, e só então segura o teto.
Isso vem depois do processamento do browser, não no lugar dele
echoCancellation e noiseSuppression continuam ligados: os dois resolvem problemas diferentes. O do browser é treinado em ruído estacionário dentro do pipeline de captura; este corta o que sobrou e decide quando a linha deve estar em silêncio.
O limiar do gate ninguém acerta no olho
Regular gate de ouvido significa ligar e escutar o que sumiu — o que só funciona se você já sabe o que deveria sumir. measureNoiseFloor ouve a sala em repouso por 3 s e devolve o pico de RMS; suggestGateThreshold põe o limiar acima dele por uma margem, porque um gate exatamente no nível do ruído fica batendo, abrindo e fechando na variação da própria sala.
O resultado é clampado nas duas pontas: sala medida como perfeitamente silenciosa daria limiar zero (gate que nunca fecha) e sala medida enquanto alguém falava daria um que nada abre.
O limiar é lido a cada tique
Mover gateThreshold no objeto de settings muda a cadeia viva — um slider não precisa reconstruir o grafo.
Ouvir a si mesmo antes de entrar na chamada
const monitor = monitorVoiceChain(previewTrack, settings, { gain });
// ao soltar o botão
monitor.stop();
Realimentação
Sem fone, a caixa alimenta o microfone que alimenta a caixa. É por isso que isto é uma ação segurada e explícita, não uma preferência — e o aviso precisa estar na sua UI, não só aqui.
Cadeia ociosa não constrói nada
isVoiceChainIdle(settings, gain) responde se algo mudaria o sinal. Com tudo desligado e ganho 1, createVoiceChain devolve o track de origem intocado e nem abre um AudioContext — browsers limitam quantos vivem ao mesmo tempo, e um aberto para uma cadeia passa-tudo conta igual. supported fica false nesse caso e também num motor sem Web Audio.
Montando você mesmo: os hooks
import { useMicrophone, useAudioRecorder } from "tempest-react-sdk";

export function GravadorProprio() {
  const mic = useMicrophone({ deviceId: undefined, noiseSuppression: true });
  const rec = useAudioRecorder(mic.stream, { maxDurationMs: 60_000 });

  return (
    <>
      <button onClick={mic.start} disabled={mic.status === "ready"}>
        Liberar microfone
      </button>
      <button onClick={rec.start} disabled={!rec.ready}>
        Gravar
      </button>
      <button onClick={() => void rec.stop()}>Parar</button>
      <meter min={0} max={1} value={rec.level} />
      <span>{rec.durationMs} ms</span>
      {mic.error && <p role="alert">{mic.error.message}</p>}
    </>
  );
}
stop() no microfone não é opcional
Soltar a última referência de um MediaStream não desliga o microfone. Cada track tem que ser parada à mão — senão o browser continua mostrando o indicador de gravação, o SO mantém o dispositivo ocupado, e o próximo getUserMedia (em outra aba do mesmo app, tipicamente) falha com NotReadableError. O useMicrophone para as tracks no stop(), no unmount e antes de reabrir.
O gravador não é dono do stream
rec.stop() deixa o microfone aberto de propósito, pra uma segunda gravação não precisar de outro round-trip de permissão. Fechar é do mic.stop().
Erros classificados
useMicrophone().error já vem traduzido de DOMException para algo em que dá pra ramificar:
kind |
Causa | Ação |
|---|---|---|
insecure |
página em HTTP puro | a correção é uma URL, não uma configuração |
unsupported |
motor sem captura | outro navegador |
permission-denied |
negado | configurações do site |
not-found |
nenhum dispositivo, ou nenhum que casa com as constraints | relaxar deviceId |
in-use |
hardware ocupado | fechar o outro app/aba |
unknown |
o resto | mostra a mensagem original |
A ordem importa: um mediaDevices ausente é quase nunca "este navegador não faz áudio" — é uma página em HTTP, onde a API inteira simplesmente não existe. Reportar unsupported ali manda o dev procurar polyfill pra um problema que um https:// resolve.
Nível de gravação
useAudioRecorder já publica level (0–1) a 10 Hz. Pra uma barra por frame, use o createLevelMeter direto e escreva no DOM:
const meter = createLevelMeter(stream);
const tick = () => {
  barra.style.transform = `scaleX(${meter.level()})`;
  raf = requestAnimationFrame(tick);
};
// ...e sempre meter.stop() no cleanup
Medidor não é enfeite
Uma entrada mutada no SO, ou um headset com o braço do mic dobrado pra cima, produz uma gravação perfeitamente bem-sucedida de silêncio — e sem nível visível o usuário só descobre depois de terminar de falar.
O valor é RMS, não pico: pico reage a uma amostra só e pisca, RMS acompanha volume percebido. O ataque é instantâneo e a queda é suavizada, que é como todo medidor de hardware se comporta — um que atrasa na subida parece "não está gravando".
Feche o AudioContext
O medidor cria um AudioContext e o stop() fecha. Navegadores limitam contextos vivos (Chrome permite ~6), então um medidor esquecido em unmount quebra todos os próximos da página. Os hooks e os componentes já fecham; se você usar o createLevelMeter cru, o stop() é seu.
Formato: o que dá e o que não dá
MediaRecorder não produz MP3 nem WAV — em nenhum navegador
Chromium e Firefox produzem Opus (em WebM ou Ogg); Safari produz AAC (em MP4). Nenhum motor implementa encoder MP3 ou WAV pra ele. O padrão do SDK negocia nessa ordem e devolve o que saiu de fato — AudioRecording.mimeType é o que o browser reportou, não o que você pediu.
Se o backend só aceita WAV, o blobToWav converte no cliente, com zero dependência: decodifica com o decoder do próprio browser (decodeAudioData) e reencoda RIFF/PCM 16-bit.
import { blobToWav } from "tempest-react-sdk";

const wav = await blobToWav(recording.blob, { mono: true, sampleRate: 16000 });
WAV custa ~10× mais bytes
A mesma nota de voz que tem 40 KB em Opus fica em torno de 500 KB em WAV a 48 kHz estéreo. { mono: true, sampleRate: 16000 } leva isso pra ~80 KB — e 16 kHz mono é o que um endpoint de speech-to-text quer de todo jeito. O reamostrador é o OfflineAudioContext, ou seja o do próprio browser, não um escrito à mão.
Se o backend só aceita MP3: transcodifique no servidor. Um encoder MP3 no cliente significa um build WASM da ordem de 150 KB no bundle de todo consumidor do SDK pra servir um formato — é a troca que este SDK não faz.
Fora do React: os primitivos
useAudioRecorder é uma casca fina em cima de um gravador que não sabe nada de
React. Quando a gravação acontece longe de um componente — num store, num
worker, numa máquina de estados — use o primitivo direto:
import { createAudioRecorder, isAudioRecordingSupported } from "tempest-react-sdk";

if (!isAudioRecordingSupported()) throw new Error("Este navegador não grava áudio");

const rec = createAudioRecorder(stream, { audioBitsPerSecond: 48_000 });
rec.start();
// ...
const recording = await rec.stop(); // { blob, mimeType, durationMs }
O handle expõe start, pause, resume, stop, cancel, mais os leitores
status() e durationMs() (que descontam o tempo pausado) e o mimeType
negociado.
| Símbolo | O que é |
|---|---|
createAudioRecorder(stream, opts) |
O gravador por trás do hook. Não é dono do stream — pare o mic você mesmo. |
isAudioRecordingSupported() |
MediaRecorder existe e algum container é produzível. |
isMediaCaptureSupported() |
A mesma pergunta para captura em geral (getUserMedia + MediaRecorder) — use antes de oferecer qualquer botão de gravar. |
pickAudioMimeType(preferred?) |
Primeiro container da lista que o browser realmente produz, ou null. |
AUDIO_MIME_CANDIDATES |
A ordem que o SDK negocia: Opus (WebM/Ogg) → AAC (MP4). |
encodeWav({ channels, sampleRate }) |
RIFF/PCM 16-bit a partir de canais Float32 — o motor do blobToWav. |
isAudioRecordingSupported() responde a pergunta certa
Checar só typeof MediaRecorder !== "undefined" deixa passar o motor que
tem a API e não produz nenhum dos containers — a falha aparece no
start(), com o usuário já esperando. Esta função checa as duas coisas.
Upload longo: chunks
const rec = useAudioRecorder(mic.stream, {
  timesliceMs: 5_000,
  onChunk: (chunk) => void upload(chunk),
});
Sem timesliceMs a gravação inteira fica em memória até o stop() — ok pra nota de voz, não ok pra uma reunião de uma hora. Os chunks não são tocáveis isoladamente: só o conjunto forma um arquivo válido.
Recap
playAudio(src, options)— som one-off no player compartilhado; retornanullse o autoplay foi bloqueado.stopAudio()para esse player.useAudio()— player privado por componente complay/stop/unlockede cleanup no unmount.createAudioPlayer()— canal isolado pra tocar sons simultâneos sem um cortar o outro.- A autoplay policy é tratada devolvendo
null; destrave o áudio na primeira interação. - O SDK não traz arquivos de áudio — você serve e passa a URL.
AudioRecorder— nota de voz completa: permissão, nível, relógio, revisão, retake.AudioPlayer— transporte pra um clipe; aceitaBlobe precisa dedurationMspra gravação nova.useMediaPermission— estado da permissão sem disparar o prompt; separa "nunca pedi" de "negado" (que é sticky).useMediaDevices— mics e saídas, reage adevicechange;labelsAvailablediz quando o seletor vale a pena.useMicrophone— stream + erro classificado;stop()precisa ser chamado ou o indicador de gravação não apaga.useAudioRecorder— status, relógio que desconta pausa, nível,maxDurationMs, chunks.blobToWav— WAV sem dependência, ~10× os bytes; MP3 fica no servidor.setAudioOutput/isAudioOutputSelectionSupported— roteamento de saída, só Chromium.createAudioBus/useAudioBus— ganho acima de 100%, limiter depois da soma esetSinkId;attach()traz a âncora do crbug.687574 que impede o grafo mudo no Chrome.